20.000 Zugriffe von ChatGPT, einer von Gemini – wie gut lässt sich KI-Traffic wirklich messen?
In meinem letzten Beitrag hatte ich beschrieben, wie sich Zugriffe von KI-Assistenten auf eine Webseite mit Matomo erfassen lassen. Dabei geht es nicht nur um Menschen, die von ChatGPT oder Perplexity auf eine Webseite gelangen. Auch die KI-Systeme selbst rufen Webseiten auf, beispielsweise um Informationen für die Antwort auf eine Frage abzurufen.
Bei der Analyse zweier Webseiten bin ich nun auf Zahlen gestoßen, die mich stutzig gemacht haben und deren Untersuchung ich hier teilen möchte.
Innerhalb des untersuchten Zeitraums verteilten sich laut Matomo die erkannten Zugriffe ungefähr so:
| KI-Assistent | Anteil |
| ChatGPT | 91 % |
| Claude | 6 % |
| Perplexity | 2 % |
| NotebookLM | 1 % |
| Le Chat | < 1 % |
| Gemini | < 1 % |
Hinter den 91 Prozent von ChatGPT stecken rund 20.000 Abrufe von Seiten und Dokumenten innerhalb einer Woche – und eine einzige (!) von Gemini.
Natürlich könnte das teilweise durch Marktanteile und die unterschiedliche Arbeitsweise der verschiedenen KI-Assistenten erklärbar sein. Aber ist eine derart große Differenz wirklich vorstellbar?
Messen wir hier tatsächlich, wie häufig KI-Systeme unsere Webseite nutzen – oder nur, wie häufig wir deren Nutzung erkennen können?
Wie erkennt man einen Zugriff durch einen KI-Assistenten?
Wenn ein Browser eine Webseite aufruft, übermittelt er normalerweise einen sogenannten User-Agent. Auch Bots und KI-Systeme können sich auf diese Weise zu erkennen geben.
Bei einigen KI-Assistenten funktioniert das gut. Ein von einem ChatGPT-Nutzer ausgelöster Abruf kann beispielsweise den User-Agent ChatGPT-User verwenden. Entsprechende Kennungen gibt es auch für Claude und Perplexity.
Im Serverlog lassen sich solche Zugriffe erkennen und anschließend beispielsweise an Matomo übermitteln. Genau darauf basiert auch die von mir im letzten Blogartikel beschriebene und eingesetzte Lösung.
Das hat allerdings eine entscheidende Voraussetzung:
Der KI-Anbieter muss einen Zugriff so kennzeichnen, dass er eindeutig erkennbar wird.
Und genau das geschieht nicht bei allen Systemen gleichermaßen.
Der Fall Gemini
Matomo unterstützt die Erkennung verschiedener KI-Assistenten. Für Gemini gehört dazu unter anderem der User-Agent Gemini-Deep-Research.
Der Name weist bereits auf eine wichtige Einschränkung hin: Dabei handelt es sich nicht um eine allgemeine Kennung für sämtliche Nutzung von Gemini. Deep Research ist eine spezielle Recherchefunktion von Gemini, mit der Nutzer umfangreichere Recherchen über zahlreiche Quellen durchführen können.
In Logfiles mehrerer Tage fand sich kein einziger Zugriff mit Gemini-Deep-Research. Andere Google-Crawler waren dagegen ausgesprochen aktiv.
Die Schlussfolgerung aus den extrem niedrigen Gemini-Zahlen lautet:
Gemini greift nicht auf die Webseiten zu, sondern verwendet entweder einen andernen User-Agent oder bedient sich aus anderen von Google bereits erfassten Daten.
Das ist ein erheblicher Unterschied beispielsweise zu ChatGPT.
Google macht die Sache noch komplizierter
Bei Google kommt ein weiterer Aspekt hinzu: KI-generierte Antworten gibt es längst nicht mehr nur im eigenständigen Gemini-Chat.
Google zeigt mit den AI Overviews KI-generierte Antworten direkt innerhalb der normalen Suchergebnisse an. Daneben gibt es einen eigenen KI-Modus, der noch stärker einer Unterhaltung mit einem KI-Assistenten ähnelt.
Dafür muss Google eine Webseite aber nicht in dem Moment neu abrufen, in dem ein Nutzer seine Suchanfrage stellt.
Google kann auf Inhalte zurückgreifen, die bereits über Googlebot erfasst und in den Google-Suchindex aufgenommen wurden. Die generativen Suchfunktionen nutzen Googles bestehende Search- und Ranking-Systeme, um passende Informationen und Quellen zu finden. Google beschreibt dabei unter anderem den Einsatz von „Query Fan-Out“: Das System kann mehrere verwandte Suchanfragen durchführen, um Informationen und Quellen für eine Antwort zusammenzutragen.
Vereinfacht kann der Weg damit so aussehen:
Webseite → Googlebot → Google-Index → KI-generierte Antwort
Für die Webanalyse entsteht dadurch ein grundsätzliches Problem.
Einen Googlebot-Aufruf können wir anhand der Serverlogs erkennen. Wir können daraus aber nicht ableiten, ob der abgerufene Inhalt später in einer normalen Google-Suche, einer AI Overview oder einer anderen Google-Funktion verwendet wird.
Es gibt in diesem Fall also möglicherweise gar keinen zusätzlichen, eindeutig als KI erkennbaren Zugriff auf die Webseite.
Eine weitere Datenquelle: die Google Search Console
Zumindest einen anderen Teil dieser KI-Nutzung macht Google inzwischen selbst sichtbar.
In der Google Search Console gibt es einen eigenen Leistungsbericht für generative KI-Funktionen in der Google Suche. Er umfasst derzeit AI Overviews und den KI-Modus.
Dort wird ausgewiesen, wie oft Links zur eigenen Webseite in diesen generativen Funktionen Nutzern angezeigt wurden. Google bezeichnet diese Einblendungen als Impressionen.
Auf meiner eigenen Webseite waren das beispielsweise innerhalb von 28 Tagen 1.264 Impressionen.
Das ist eine interessante zusätzliche Kennzahl, sie misst allerdings wieder etwas vollkommen anderes als Matomo oder die Serverlogs.
Eine Impression bedeutet hier, dass ein Link zu meiner Webseite in einer generativen Google-Funktion angezeigt wurde. Sie bedeutet nicht, dass Google meine Webseite zu diesem Zeitpunkt neu abgerufen hat. Und sie sagt auch nicht, wie häufig Google meine Inhalte tatsächlich zur Generierung einer Antwort verwendet hat.
Bei einem meiner Artikel über die Arbeit mit Zielen in Matomo zeigte die Search Console besonders viele solcher Impressionen. Also habe ich selbst ausprobiert, ob ich eine davon reproduzieren kann.
Und ja: Google verwendete meinen Artikel sowohl in einer AI Overview als auch im separaten KI-Modus als Quelle.
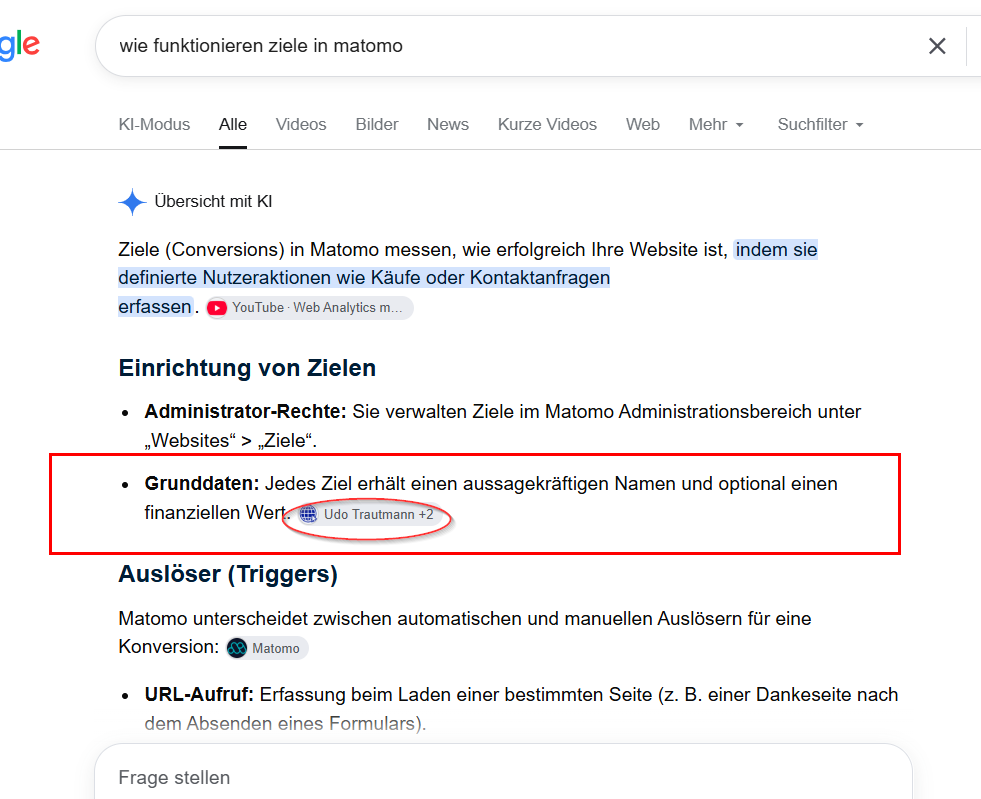
Googles AI Overview zeigt einen Link an. In der Google Search Console führt das zu einer Impression für KI-generative Funktionen.
Interessant wurde es, als ich auf den Link zu meiner Webseite klickte.
Der KI-Besucher, der in Matomo gar keiner ist
Ich konnte meinen eigenen Klick unmittelbar anschließend im Besucherlog von Matomo nachvollziehen.
Matomo klassifizierte den Besuch jedoch nicht als KI-Traffic, sondern als ganz normalen Besuch aus einer Suchmaschine.
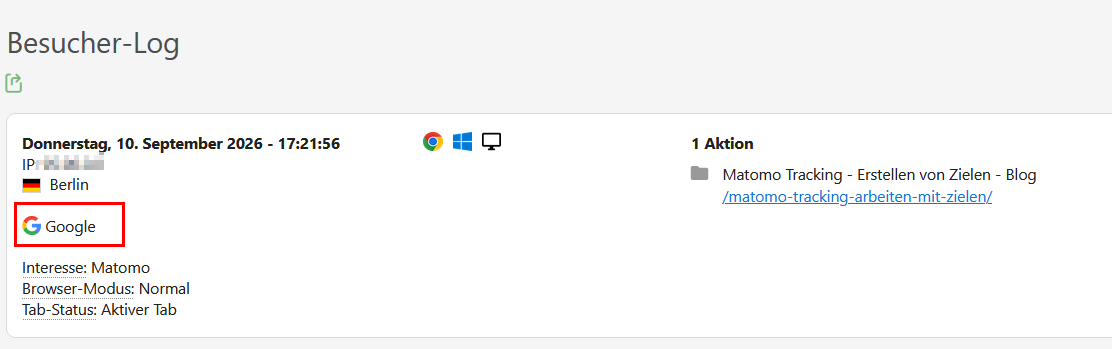
Der Aufruf aus dem AI Overview von Google wird in Matomo organischem Traffic (Suchmaschinen) zugeordnet,
Der Grund war im Besucherlog ebenfalls zu erkennen. Als Referrer wurde Google.com übermittelt. Der Link enthielt dagegen keinen UTM-Parameter oder ein anderes für Matomo erkennbares Merkmal, anhand dessen sich der Besuch einer AI Overview oder dem KI-Modus hätte zuordnen lassen.
Ich habe den Versuch mehrfach wiederholt – sowohl über eine AI Overview als auch über den KI-Modus. Das Ergebnis blieb gleich.
Interessanterweise zeigte sich bei einem zusätzlichen Test mit einer KI-generierten Antwort von Bing dasselbe Verhalten: Der Klick erschien in Matomo als ganz normaler organischer Bing-Traffic.
Damit wurde eine weitere Messlücke sichtbar:
Ein Besucher kann nachweislich aus einer KI-generierten Antwort einer Suchmaschine kommen und in der Webanalyse trotzdem wie ein klassischer Suchmaschinenbesucher aussehen.
Ein Teil des durch KI-generierte Suchergebnisse vermittelten Traffics kann damit im ganz normalen Organic-Traffic stecken.
Und dann ist da noch Grok
Bei Grok, der KI von xAI, wird es noch schwieriger.
Während OpenAI, Anthropic oder Perplexity relativ eindeutige Spuren hinterlassen können, ist mir derzeit keine vergleichbar verlässliche Kennung für einen nutzerinitiierten Abruf durch Grok bekannt.
Auch die öffentlich auffindbaren Angaben zu möglichen Grok-User-Agents sind widersprüchlich. Es werden unterschiedliche Kennungen genannt, teilweise wird von generischen Browser- oder HTTP-User-Agents berichtet.
Das wäre nebenbei auch eine mögliche Erklärung dafür, warum manche Webseiten auffällige Zugriffe scheinbar normaler Besucher verzeichnen, die beispielsweise sehr hohe Zugriffsmengen oder immer wieder einzelne Bounce-Besuche erzeugen und aus den USA stammen.
Das ist allerdings kein Beleg, sondern lediglich eine mögliche Erklärung. Es wäre spekulativ, einen solchen User-Agent ohne weitere Anhaltspunkte als Grok-Zugriff zu zählen.
Hinzu kommt ein zweites Problem: Wenn ein Mensch aus einer KI-Anwendung wie Grok auf eine Webseite klickt, wird die Herkunft Stand heute weder im Referrer oder UTM-Parameter übertragen.
Ein fehlender Grok-Eintrag in einer Webanalyse bedeutet deshalb noch lange nicht, dass Grok keine Inhalte dieser Webseite verwendet hat oder keine Besucher von dort gekommen sind.
Was messen wir also eigentlich?
An diesem Punkt lohnt sich eine klare Trennung. Unter „KI-Traffic“ werden häufig vollkommen unterschiedliche Vorgänge zusammengefasst.
Die KI besucht die Webseite
Ein KI-Assistent ruft aufgrund einer Nutzerfrage eine Seite ab. Wenn er sich dabei eindeutig zu erkennen gibt, lässt sich dieser Zugriff im Serverlog identifizieren und beispielsweise mit Matomo auswerten.
Ein Mensch kommt von einer KI auf die Webseite
Ein Nutzer klickt auf eine Quellenangabe in ChatGPT, Perplexity, Gemini, Grok oder einem anderen System. Das ist ein normaler Webseitenbesuch. Ob wir seine Herkunft erkennen, hängt unter anderem davon ab, welche Referrer-Informationen oder UTM-Parameter das KI-System übermittelt.
Meine Tests mit Google und Bing zeigen allerdings: Auch ein nachweislich aus einer KI-generierten Antwort stammender Klick kann in der Webanalyse einfach als Akquisition unter Suchmaschinen erscheinen.
Die Webseite erscheint in einer generativen Suchfunktion
Google stellt hierfür inzwischen mit der Search Console eine weitere Perspektive bereit. Sie kann zeigen, wie häufig Links einer Webseite in AI Overviews und im KI-Modus eingeblendet wurden.
Das ist Sichtbarkeit in einer generativen Suchfunktion – aber weder ein Webseitenbesuch noch ein direkter Abruf durch einen KI-Assistenten.
Eine KI verwendet Inhalte, ohne einen neuen erkennbaren Zugriff zu erzeugen
Ein KI-System greift auf bereits erfasste oder indexierte Informationen zurück. Dann kann die Webseite Bestandteil einer KI-generierten Antwort sein, ohne dass zu diesem Zeitpunkt irgendein eindeutig als KI erkennbarer Request im Serverlog entsteht.
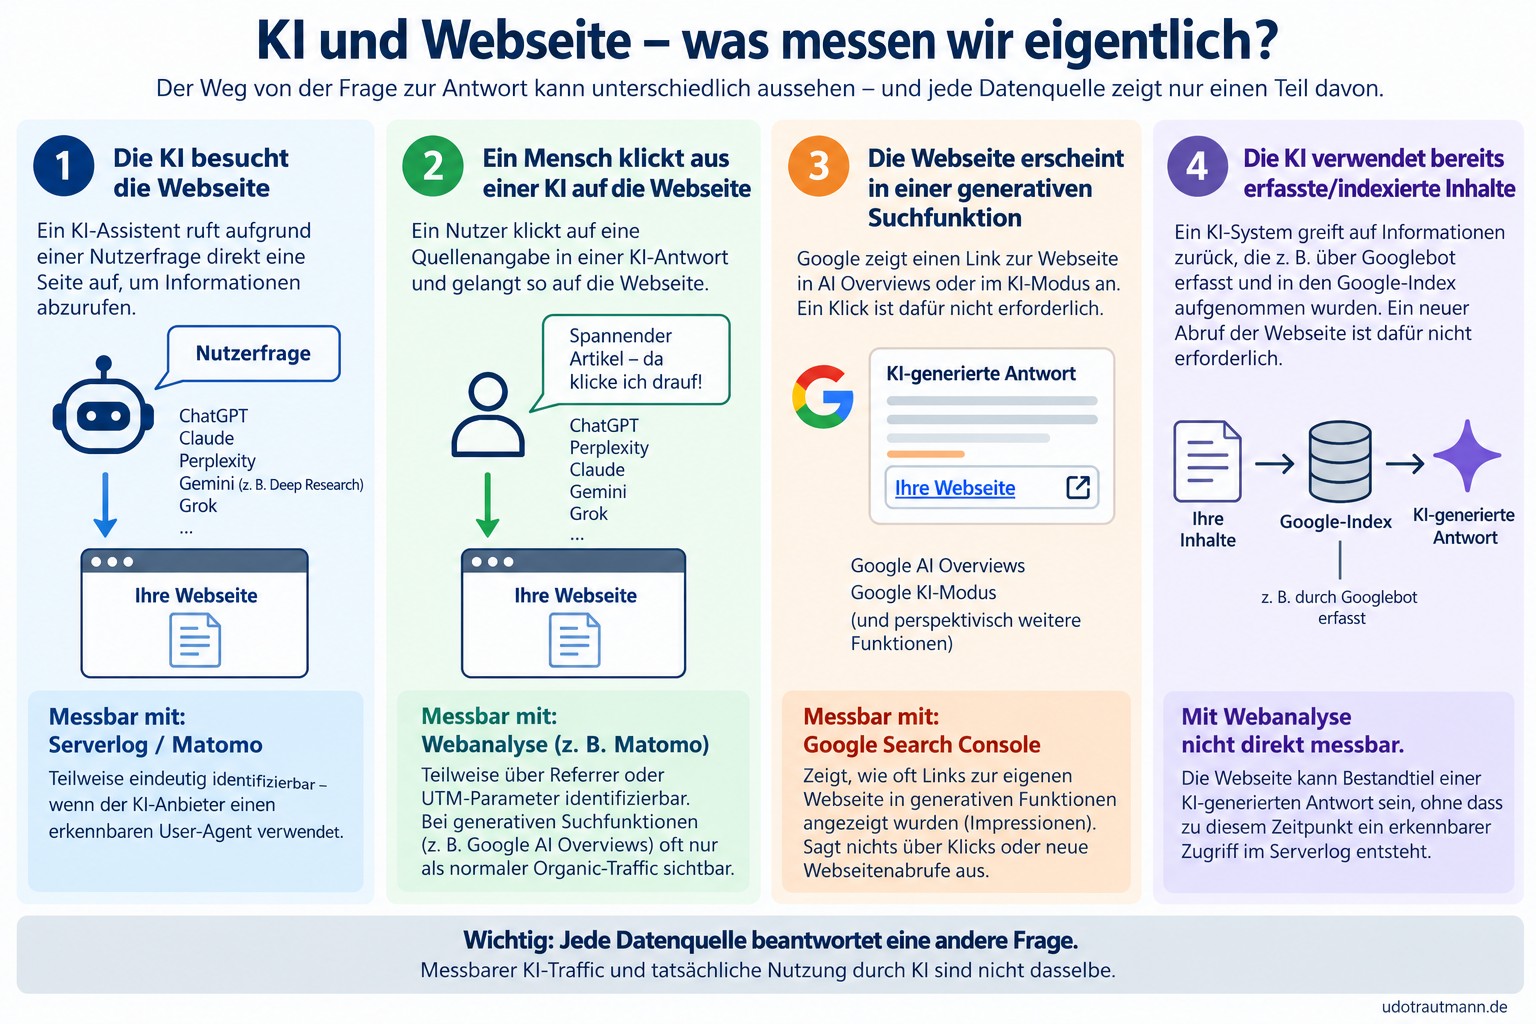
Jede Datenquelle für KI-Traffic zeigt andere Daten
20.000 zu 1 bedeutet also nicht 20.000 zu 1
Damit komme ich zurück zu den Zahlen vom Anfang.
Die gemessenen 20.000 ChatGPT-Anfragen gegenüber einer Gemini-Anfrage zeigen zunächst einmal einen gewaltigen Unterschied in den erkennbaren Zugriffen.
Sie beweisen jedoch nicht, dass ChatGPT die Inhalte dieser Webseite tatsächlich 20.000-mal häufiger verwendet hat als Gemini.
Die verschiedenen Systeme beschaffen Informationen unterschiedlich. Vor allem aber unterscheiden sie sich darin, welche Spuren sie dabei auf der Webseite hinterlassen.
Das gilt erst recht, wenn wir nicht nur ChatGPT und Gemini betrachten, sondern auch Google AI Overviews, den KI-Modus oder ein derzeit schwer identifizierbares System wie Grok.
Ist die Messung von KI-Traffic damit wertlos?
Ganz im Gegenteil.
Die Zahlen würden nur dann problematisch, wenn wir sie falsch interpretieren und ihnen eine Bedeutung geben, die sie nicht haben.
Wenn ich mit Matomo und den Serverlogs mehrere tausend ChatGPT-User-Anfragen messe, ist das eine wertvolle Information:
ChatGPT hat einzelne Inhalte einer Webseite tatsächlich mehrere tausend Mal mit dieser identifizierbaren Kennung abgerufen.
Man sollte daraus aber nicht automatisch schließen, welchen Anteil diese Inhalte an Antworten von ChatGPT hatten – und schon gar nicht anhand der Größenverhältnisse verschiedener KI-Systeme deren tatsächliche Nutzung miteinander vergleichen.
Für eine sinnvolle Analyse müssen deshalb mehrere Perspektiven zusammenkommen: die Zugriffe der KI-Systeme selbst, die Besucher, die von KI-Angeboten auf die Webseite gelangen, und zusätzliche Datenquellen. Bei Google gehört dazu inzwischen beispielsweise der Bericht zu generativen KI-Funktionen in der Google Search Console.
Jede dieser Datenquellen beantwortet eine andere Frage.
Entscheidend ist deshalb zu wissen, was eine Kennzahl tatsächlich misst – und was nicht.
Mein Fazit
Die entscheidende Frage lautet also nicht ausschließlich:
„Wie viel KI-Traffic habe ich?“
sondern muss ergänzt werden:
„Welchen Teil der KI-Nutzung kann ich mit meinen Daten überhaupt sehen?“
Matomo, Serverlogs und zusätzliche Datenquellen wie die Google Search Console können darauf bereits interessante Antworten geben. Sie liefern aber keinen vollständigen Blick darauf, wie KI-Systeme die Inhalte einer Webseite tatsächlich nutzen.
Somit lautet das Fazit: Messbarer KI-Traffic und tatsächliche Nutzung durch KI sind nicht dasselbe.
Kundenstimmen aus meinen Projekten

Ihnen hat mein Artikel gefallen?
Lassen Sie sich per Newsletter über meine neuen Blog-Beiträge zu Matomo informieren.
Als Dankeschön erhalten Sie mein Gratis-E-Book
„Die 10 besten kostenlosen Matomo-Plugins“.
